 Метаверсище и ИИще
Открытые веса мультимодальной модели Inkling 2 Small от Thinking Machines
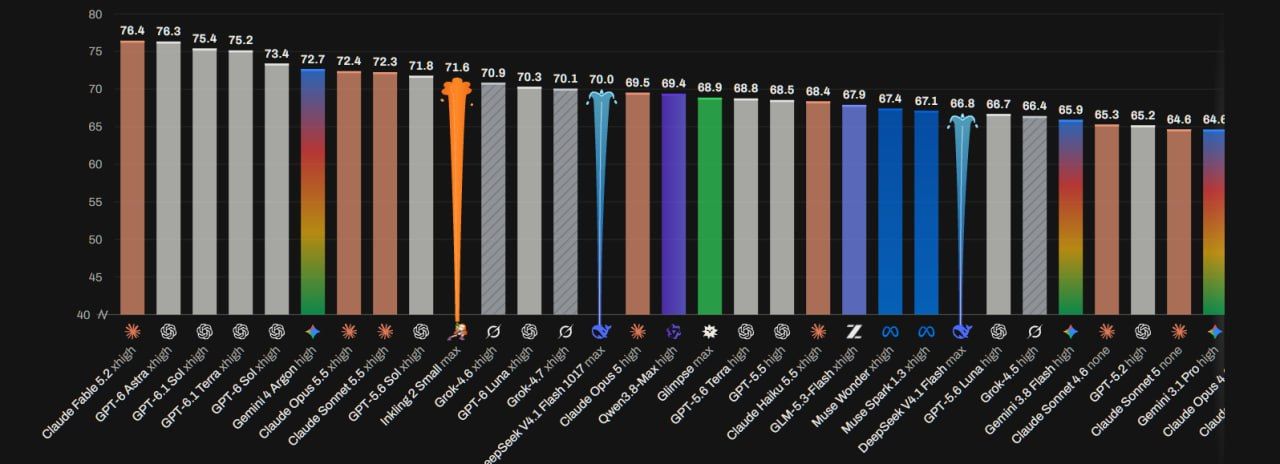
Thinking Machines Lab опубликовала открытые веса мультимодальной модели Inkling 2 Small с архитектурой Mixture-of-Experts под лицензией Apache 2.0.
Технические характеристики архитектуры
Модель представляет собой 48-слойный декодерный трансформер объемом 594 млрд параметров, из которых на каждый токен активируется 17 млрд. Архитектура использует маршрутизацию в 8 из 384 экспертов и сочетает локальное и глобальное внимание для обработки контекста до 1 млн токенов.
Встроенный ViT-кодировщик проецирует изображения разрешением от 40px до 4096px в общее скрытое пространство с текстом. Обучение проводилось нативно в низкобитном формате NVFP4, что делает этот чекпоинт основным решением.
Системные требования и развертывание
Для запуска основного чекпоинта NVFP4 требуется суммарно от 500 ГБ видеопамяти, например, на конфигурации 2x NVIDIA B300 или 4x NVIDIA H200. Альтернативный вариант MXFP8 требует от 800 ГБ VRAM и дает лишь незначительный прирост точности.
Инференс доступен сразу после публикации через готовые рецепты для vLLM (с нативным спекулятором DSpark), SGLang, TokenSpeed и Unsloth.
Для дообучения и использования API поддерживаются Tinker Cookbook, Miles, SkyRL, а также хостинг на платформах NVIDIA, Together, Fireworks, Baseten, Nebius, Modal и Cloudflare.