 Метаверсище и ИИще
Baidu представила Unlimited-OCR 2 для распознавания длинных документов
Компания Baidu представила модель Unlimited-OCR 2 для распознавания документов практически любой длины. Система извлекает текст из сканов и PDF, обрабатывает таблицы, формулы и многостраничные материалы.
Проблема длинных контекстов в OCR
Современные модели на базе LLM требуют всё больше вычислений и памяти при обработке длинных документов. Это связано с необходимостью постоянного обращения к растущему объёму предыдущего контекста.
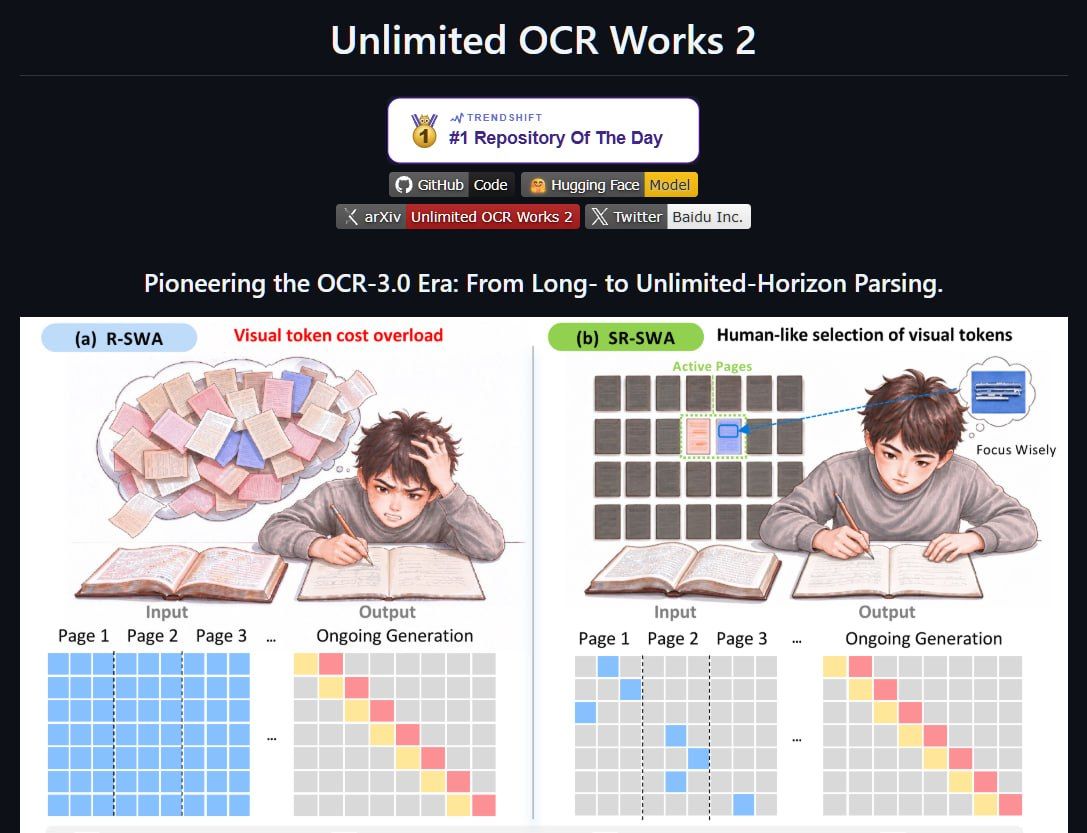
Первая версия частично решала проблему, ограничивая историю генерации, но визуальные данные создавали нагрузку. Baidu предложила механизм Sparse Reference Sliding Window Attention (SR-SWA) для оптимизации процесса.
Как работает новый механизм
Идея механизма проста: при распознавании фрагмента модель фокусируется на текущей странице и обращается лишь к небольшому набору полезных частей документа. Вместо просмотра всей информации используется ограниченная рабочая память.
Например, система может использовать 512 опорных токенов. Вычислительная стоимость каждого шага остаётся постоянной даже при увеличении длины документа. Дополнительно применяется обработка страниц перекрывающимися блоками для освобождения памяти.
Результаты тестирования и доступность
По тестам Baidu, на документах около 100 страниц ускорение отдельных шагов декодирования достигает 7 раз относительно полного внимания и 5,6 раза по сравнению с предыдущим механизмом. Модель содержит около 3 млрд параметров.